19 Nov, 2026
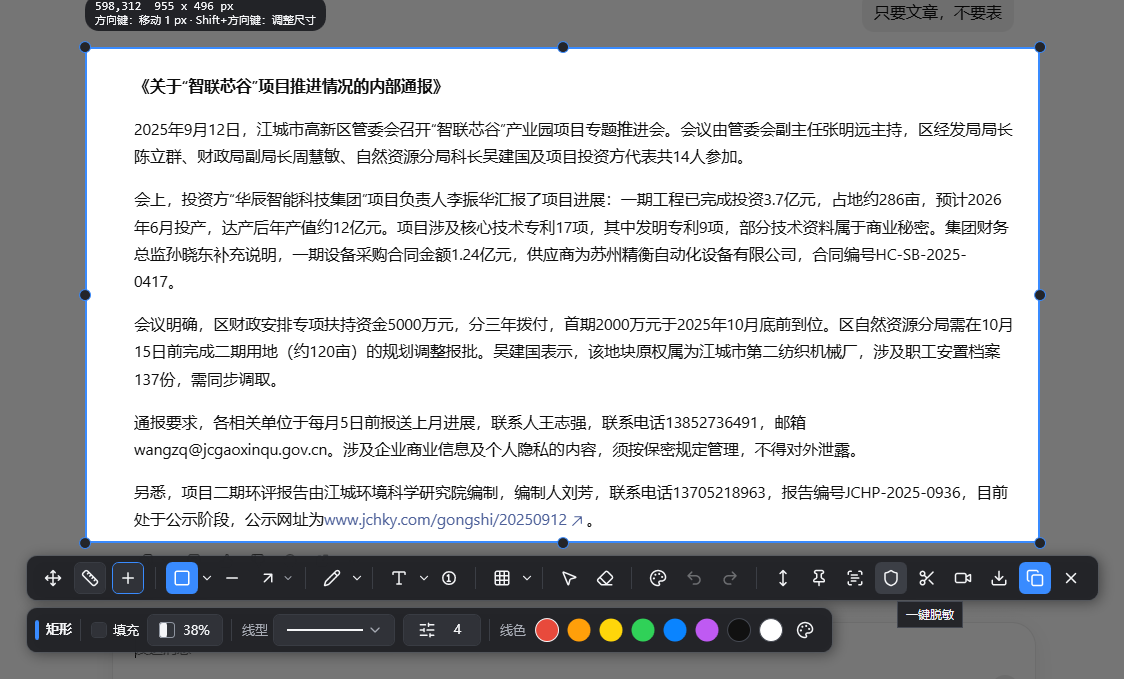
写技术博客、提工单、把报错截图丢给 AI、往群里甩后台页面……每次最烦的不是截图,是截图之后还要手动打码。手机号、邮箱、IP、token、客户名、订单号,漏一个就心惊胆战。 SnapSharp 之前已经有马赛克和模糊,但那是”画笔”——你得自己框、自己涂。这次我加了一个新能力:一键脱敏。 项目地址: 由于需要本地AI检测脱敏范围,所以脱敏快慢靠计算机性能 一、为什么做”一键脱敏” 原来的流程是这样的: Ctrl+Shift+A 截图 选马赛克笔 对着手机号涂一下 对着邮箱涂一下 对着右上角账号名再涂一下 发现底下日志里还有个 IP……重涂 痛点不是”没有打码工具”,而是”打码太手工”。 我希望的目标是:截图完,点一个按钮,本地 OCR 跑一遍,邮箱、手机、IP、密钥、证件号、自定义关键词自动识别位置,直接不可逆打码,全程不上传、不碰云。 二、一键脱敏怎么用 截图后,在工具栏点「一键脱敏」,或者绑定一个快捷键(示例 Ctrl+Shift+R)。 它会做三件事: 对当前截图做本地 OCR 用规则匹配敏感片段 在识别框的位置上直接叠马赛克 / 模糊…
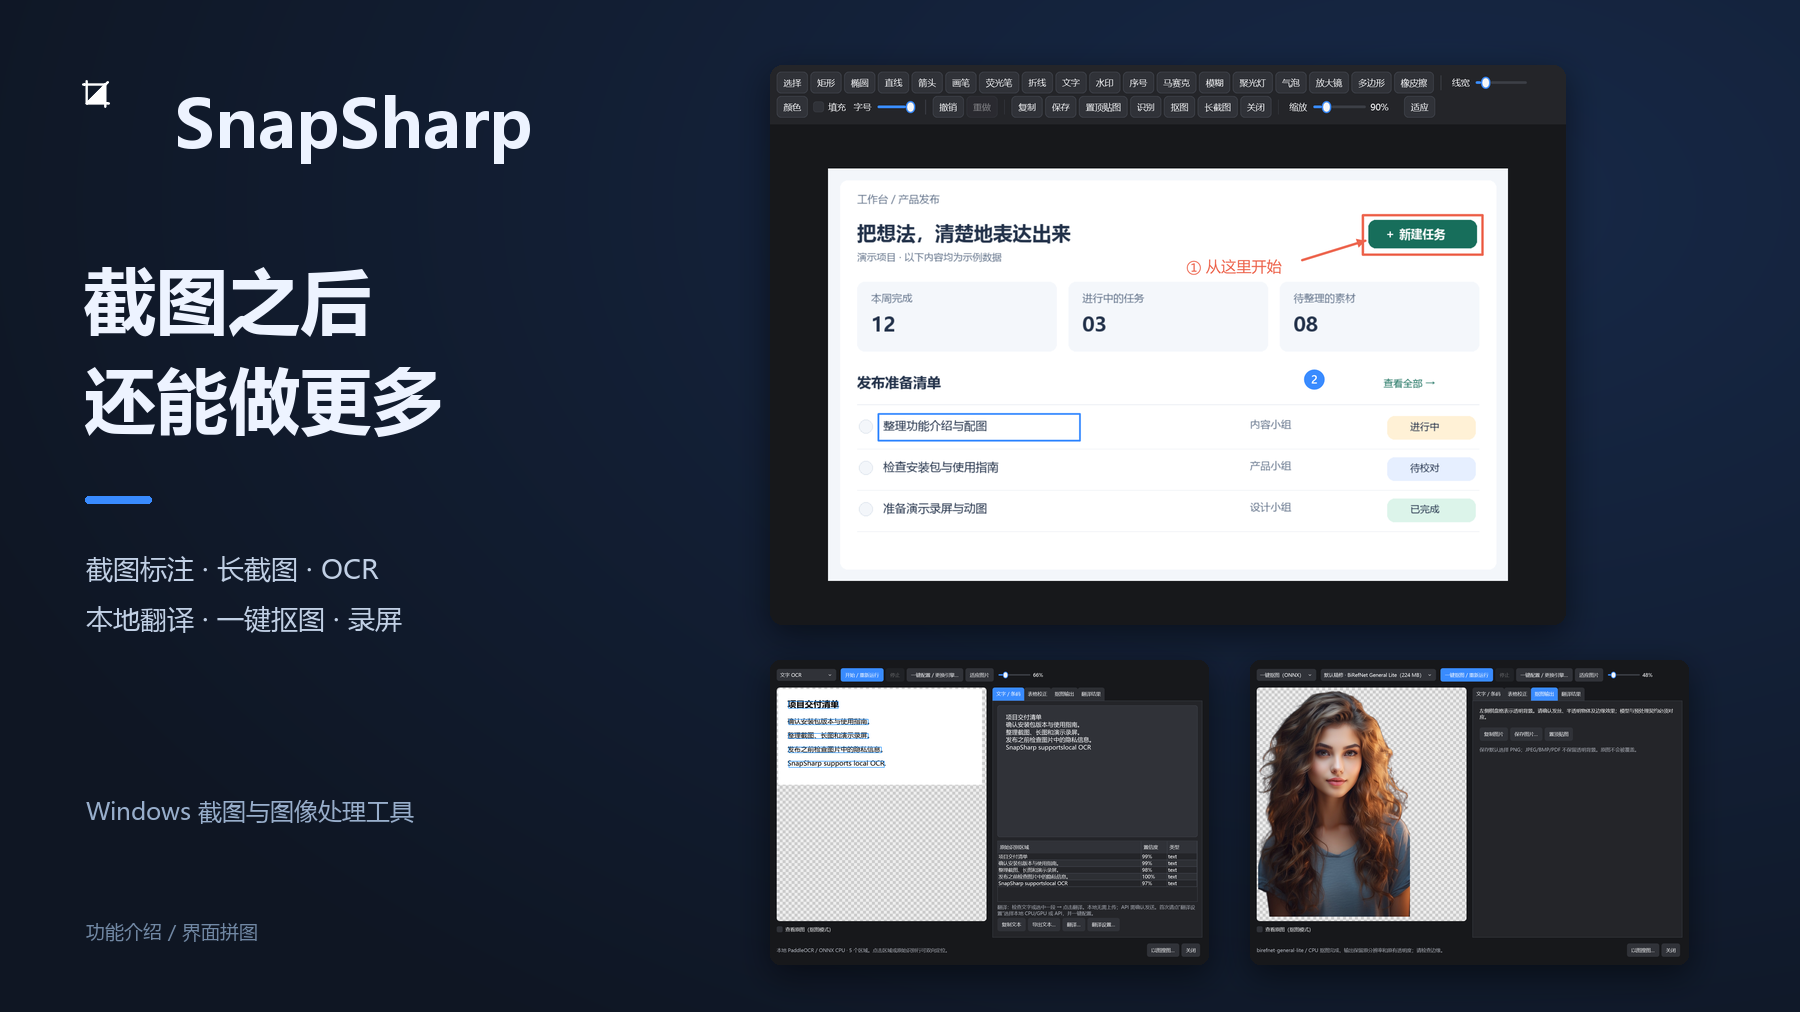
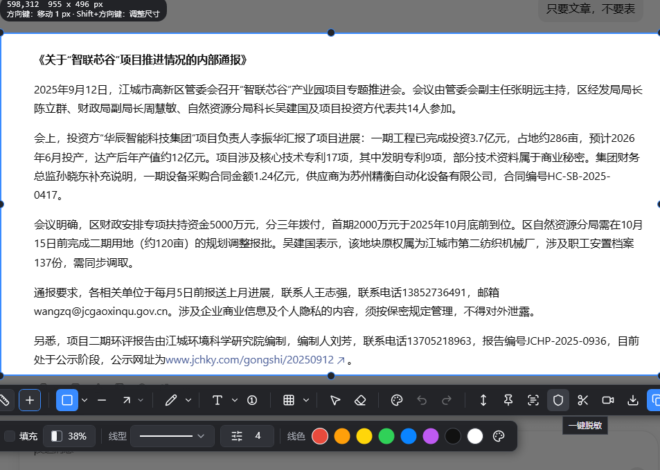
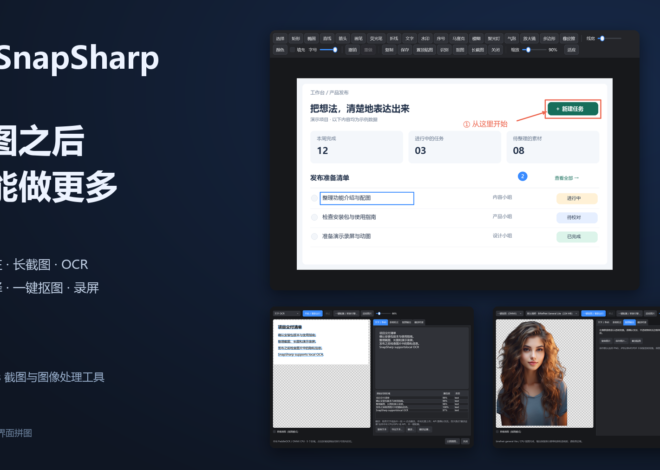
# SnapSharp:把截图、标注、OCR、翻译和 AI 抠图放进一款 Windows 工具 写技术博客的时候,一张截图往往只是开始。 截完界面,要用箭头标出操作入口;拿到一段图片里的英文,需要先识别,再翻译;遇到表格,又希望直接导入 Excel。为了说明连续操作,还可能需要录一段 GIF。 这篇文章介绍的 **SnapSharp**,就是把这些操作集中在一起的一款 Windows 截图与图像处理工具。它既有截图、标注、桌面贴图这些日常功能,也支持通过本地模型完成文字识别、表格识别、公式识别、背景移除和翻译。 项目地址:[Gitee]( · [GitHub](   ## 一、从截图开始,顺手把说明写清楚 SnapSharp 启动后驻留在任务栏托盘。日常使用不需要先打开一个主窗口,按 `Ctrl+Shift+A` 就能开始框选区域。 框选后,可以直接添加矩形、椭圆、箭头、文字、序号和荧光笔。需要遮挡内容时,也可以使用马赛克或模糊。除了矩形选区,还支持椭圆、自由套索和多边形选区。 对于技术文章,我比较看重的是“把步骤说清楚”:用矩形框出目标区域,用箭头指出点击入口,再加上序号和一句说明,读者就能按顺序操作。 *上图使用示例内容展示标注效果。* 标注还支持选择、移动、缩放、旋转、调整层级,以及撤销和重做。画错了或者位置不合适,可以继续调整。 下面这张文章截图展示了另一种用法:直接在资料上添加箭头、高亮和说明,适合整理阅读笔记,也适合反馈问题。 完成后可以复制、保存,或者把结果置顶贴到桌面。如果需要提取文字或去掉背景,也能继续进入识别处理流程。…
【摘要】Avalonia Headless 实战:不开显示器,也能测点击、打字和快捷键 用 Avalonia 的 headless 平台在 CI 里跑真实窗口:真实控件树、真实布局、真实输入管线,只把"屏幕"和"鼠标键盘"换成内存实现。本文从最小工程讲到键鼠输入细节,附可直接照抄的例子与踩坑清单。 一、He 阅读全文 PakarPBN A Private Blog Network (PBN) is a collection of websites that are controlled by a single individual…
装了11.8又装12.x,切了环境nvcc版本还是不对?这不是装错,是PATH排序问题。本机三场景实测证明:谁生效由PATH队列最前的那个决定,与版本新旧、安装先后无关。排查第一命令是where.exe,一条列出全部候选与真实生效者。 本文是《AI工程师踩坑实录》系列第 6 篇。机器上装了 11.8 又装了 12.x,conda 环境也切了,nvcc 给出的版本还是不对,训练时莫名报库找不到。这一篇在本机用两个真实的 CUDA 工具链版本做对照实验,把「谁在生效」的裁判规则讲透。 本篇配套的三场景复现命令放在公Z号关注私信领取。 这个坑的典型剧本是这样的。 机器上装了两套 CUDA,比如一套 11.8 一套 12.6。你在 conda 环境里切来切去,敲 nvcc -V,显示的还是你不想要的那套。编译扩展的时候报一堆库找不到,报错指向的路径你根本没印象装过。 第一反应通常是,是不是没装好,卸了重装。装完,还是串。 问题从来不是「装没装」,是「谁排在前面」。今天用本机实验把这条规则钉死。 一、实验设置:两套真实 CUDA 工具链 我在本机准备了两套并存的 CUDA 编译工具链组件,一套…
初学文档处理或多模态应用时,常会碰到 OCR、VLM、ASR 这几个缩写。它们都和“把信息变成文字或答案”有关,但分工完全不同。笔者用一句话先概括:OCR 负责抄字,VLM 负责看懂画面并推理,ASR 负责把声音转成文字。 flowchart LR A[“声音”] –>|ASR| B[“文字”] C[“图片中的文字”] –>|OCR| D[“文字 + 坐标”] E[“整张图片(物体 + 文字 + 布局)”] –>|VLM| F[“回答 / 摘要 / JSON”] D –> G[“后续…

给 SnapSharp 加了「一键脱敏」:截图发出去之前,先把敏感信息糊掉 – liessay

写技术博客、提工单、把报错截图丢给 AI、往群里甩后台页面……每次最烦的不是截图,是截图之后还要手动打码。手机号、邮箱、IP、token、客户名、订单号,漏一个就心惊胆战。 SnapSharp 之前已经有马赛克和模糊,但那是”画笔”——你得自己框、自己涂。这次我加了一个新能力:一键脱敏。 项目地址: 由于需要本地AI检测脱敏范围,所以脱敏快慢靠计算机性能 一、为什么做”一键脱敏” 原来的流程是这样的: Ctrl+Shift+A 截图 选马赛克笔 对着手机号涂一下 对着邮箱涂一下 对着右上角账号名再涂一下 发现底下日志里还有个 IP……重涂 痛点不是”没有打码工具”,而是”打码太手工”。 我希望的目标是:截图完,点一个按钮,本地 OCR 跑一遍,邮箱、手机、IP、密钥、证件号、自定义关键词自动识别位置,直接不可逆打码,全程不上传、不碰云。 二、一键脱敏怎么用 截图后,在工具栏点「一键脱敏」,或者绑定一个快捷键(示例 Ctrl+Shift+R)。 它会做三件事: 对当前截图做本地 OCR 用规则匹配敏感片段 在识别框的位置上直接叠马赛克 / 模糊 / 黑条 支持识别并处理的类型: 手机号、固定电话 邮箱地址 IPv4 / 内网地址 身份证号、银行卡号 sk-、ghp_、AKIA、Bearer 等密钥特征 自定义规则(比如你们内部的订单号格式) 默认策略是宁可多盖,不可漏盖。盖错了可以 Ctrl+Z 单独撤掉某一块。 三、几个设计取舍 1. 本地优先,绝不联网 OCR 用的是 Windows 本地引擎或已下载的 PaddleOCR 模型,脱敏过程全程离线。适合内部系统截图、客户数据、含 token […]

1 min read
SnapSharp:把截图、标注、OCR、翻译和 AI 抠图放进一款 Windows 工具 – liessay

# SnapSharp:把截图、标注、OCR、翻译和 AI 抠图放进一款 Windows 工具 写技术博客的时候,一张截图往往只是开始。 截完界面,要用箭头标出操作入口;拿到一段图片里的英文,需要先识别,再翻译;遇到表格,又希望直接导入 Excel。为了说明连续操作,还可能需要录一段 GIF。 这篇文章介绍的 **SnapSharp**,就是把这些操作集中在一起的一款 Windows 截图与图像处理工具。它既有截图、标注、桌面贴图这些日常功能,也支持通过本地模型完成文字识别、表格识别、公式识别、背景移除和翻译。 项目地址:[Gitee]( · [GitHub](   ## 一、从截图开始,顺手把说明写清楚 SnapSharp 启动后驻留在任务栏托盘。日常使用不需要先打开一个主窗口,按 `Ctrl+Shift+A` 就能开始框选区域。 框选后,可以直接添加矩形、椭圆、箭头、文字、序号和荧光笔。需要遮挡内容时,也可以使用马赛克或模糊。除了矩形选区,还支持椭圆、自由套索和多边形选区。 对于技术文章,我比较看重的是“把步骤说清楚”:用矩形框出目标区域,用箭头指出点击入口,再加上序号和一句说明,读者就能按顺序操作。 *上图使用示例内容展示标注效果。* 标注还支持选择、移动、缩放、旋转、调整层级,以及撤销和重做。画错了或者位置不合适,可以继续调整。 下面这张文章截图展示了另一种用法:直接在资料上添加箭头、高亮和说明,适合整理阅读笔记,也适合反馈问题。 完成后可以复制、保存,或者把结果置顶贴到桌面。如果需要提取文字或去掉背景,也能继续进入识别处理流程。   ## 二、OCR:把图片里的文字拿出来 图片中的文字不能直接选中,是整理资料时经常遇到的问题。例如一张报错截图、一段扫描内容,或者别人发来的操作说明。 复制图片后,从托盘打开“识别粘贴板图片…”,即可选择处理模式。文字 OCR、条码、表格、公式和一键抠图共用一个识别窗口。 ### 中文和英文都能识别 下面是中文清单的本地 PaddleOCR 识别示例。左侧显示文字定位框,右侧可以查看识别文本和各行置信度,便于对照原图检查。 英文内容也可以提取为可编辑文本,随后复制、导出,或者继续翻译。 如果内容比较长,可以结合文字定位框与原始识别行逐段校对。下图是较长英文资料的识别界面。 SnapSharp 提供 PaddleOCR、Windows OCR 和 Tesseract 三种本地引擎。其中 PaddleOCR 可以选择 CPU 或 DirectML […]

2 mins read

Avalonia-Headless-UI测试实战 – 首席装逼官

【摘要】Avalonia Headless 实战:不开显示器,也能测点击、打字和快捷键 用 Avalonia 的 headless 平台在 CI 里跑真实窗口:真实控件树、真实布局、真实输入管线,只把"屏幕"和"鼠标键盘"换成内存实现。本文从最小工程讲到键鼠输入细节,附可直接照抄的例子与踩坑清单。 一、He 阅读全文 PakarPBN A Private Blog Network (PBN) is a collection of websites that are controlled by a single individual or organization and used primarily to build backlinks to a “money site” in order to influence its ranking in search engines such as Google. The […]

1 min read

手把手教你:装了两套 CUDA 还在串?PATH 与优先级的真相|AI工程师踩坑实录·第6篇 – 大雾的小屋

装了11.8又装12.x,切了环境nvcc版本还是不对?这不是装错,是PATH排序问题。本机三场景实测证明:谁生效由PATH队列最前的那个决定,与版本新旧、安装先后无关。排查第一命令是where.exe,一条列出全部候选与真实生效者。 本文是《AI工程师踩坑实录》系列第 6 篇。机器上装了 11.8 又装了 12.x,conda 环境也切了,nvcc 给出的版本还是不对,训练时莫名报库找不到。这一篇在本机用两个真实的 CUDA 工具链版本做对照实验,把「谁在生效」的裁判规则讲透。 本篇配套的三场景复现命令放在公Z号关注私信领取。 这个坑的典型剧本是这样的。 机器上装了两套 CUDA,比如一套 11.8 一套 12.6。你在 conda 环境里切来切去,敲 nvcc -V,显示的还是你不想要的那套。编译扩展的时候报一堆库找不到,报错指向的路径你根本没印象装过。 第一反应通常是,是不是没装好,卸了重装。装完,还是串。 问题从来不是「装没装」,是「谁排在前面」。今天用本机实验把这条规则钉死。 一、实验设置:两套真实 CUDA 工具链 我在本机准备了两套并存的 CUDA 编译工具链组件,一套 12.6.85,一套 12.9.86,分别装在两个独立的环境目录里(用的是 pip 轮子分发的 CUDA 工具链组件 ptxas,它就是官方 CUDA 安装包里 bin 目录下的那个 ptxas.exe,版本行为与 nvcc 完全一致,这样演示不用动系统级安装)。 现在机器上同时存在两套 CUDA 工具链,各自待在自己的目录里。接下来只动一个东西,PATH 的顺序。 二、三场景实测,同一个命令三种结果 场景一,PATH 里只有 A(12.6.85)。 where.exe 找到唯一一个 ptxas,版本 […]

2 mins read

OCR、VLM、ASR 到底有什么区别?一文讲清 – AlfredZhao – 博客园

初学文档处理或多模态应用时,常会碰到 OCR、VLM、ASR 这几个缩写。它们都和“把信息变成文字或答案”有关,但分工完全不同。笔者用一句话先概括:OCR 负责抄字,VLM 负责看懂画面并推理,ASR 负责把声音转成文字。 flowchart LR A[“声音”] –>|ASR| B[“文字”] C[“图片中的文字”] –>|OCR| D[“文字 + 坐标”] E[“整张图片(物体 + 文字 + 布局)”] –>|VLM| F[“回答 / 摘要 / JSON”] D –> G[“后续 LLM 解析”] F –> H[“需校验,抑制幻觉”] 01 | OCR:字符级精准提取 OCR 全称 Optical Character Recognition,即光学字符识别。它的目标是字符级精准提取:检测文字框、识别每个字符,输出文本和坐标。 OCR 知道“写了什么”,但不知道“是什么意思”,也不会推理。它的输出通常包含原文、坐标框和置信度,确定性强。速度上,OCR 通常比 VLM 快,轻量模型在 CPU 上也能运行,单张小图可到毫秒级;实际耗时取决于模型、图片分辨率和批量,成本也随部署方式变化。在干净印刷文档上,它的准确率更高,字符更稳。 典型例子有 PaddleOCR、Tesseract、阿里云文字识别。 02 | VLM:看懂画面并理解文字 […]

2 mins read

XXL-AI v1.5.0 发布|AI应用开发平台 – 许雪里

Release Notes 【本地版(Desk 桌面端)】 1、【能力】会话压缩与记忆: 会话上下文结构化:system(系统指令 + 长期记忆 + skill技能 + 会话摘要)+ messages(短期记忆/会话)+ tools(内置工具 + MCP工具) 会话上下文使用率:计算公式 = 上下文token消耗 / 模型ContextWindow; 会话压缩:针对历史会话提炼背景/目标/进展等提炼,压缩为 max 定长(2000)摘要信息。会话上下文传递短期记忆时:需传递摘要信息与上次摘要后全部增量对话信息。每轮会话后都会触发异步压缩摘要,如果「上下文使用率超过80% 或 对话轮次超过20次 或 压缩摘要不存在」,需要主动压缩一次; 长期记忆:项目维度跨会话的画像/偏好/事实/目标/进展等长期记忆沉淀。会话完成时异步触发记忆生成/保鲜,「检测记忆为空 或 距离上次记忆生成超5min」,需要主动生成一次记忆;项目设置里,支持手动查看管理记忆;(项目 列表,启用记忆 列名改为 长期记忆;新增 记忆生成时间 列;) 2、【重构】产品设计重构: 扩展中心:插件中心更名扩展中心,现有MCP、SKILL和内置工具之外,新增 “Agent”功能;支持创建管理多Agent,Agent支持设置 指令、SKILL、MCP和内置工具等; 会话新建:新建会话时,当前会话框底部限制必选 项目;新增必选 Agent,Agent下拉框中限制Agent列表与新建Agent入口,参考项目选项交互; 系统设置:新增 项目 设置,支持管理维护 项目列表;支持新增项目、重命名、在Finder中显示、删除等;支持长期记忆开关、长期记忆查看; 会话与Agent绑定,会话时使用的 系统指令、SKILL、MCP、内置工具等,从对应Agent上获取,Agent修改后需要实时感知最新的; 3、【安全】权限管控:升级三档权限模式「仅可查看(全局读)、工作区内修改(全局读 + 项目&系统临时目录写)、完全权限(全局读写)」;同时,兜底保留统一的敏感操作拦截机制;(read-only、workspace-write、full-access) 4、【推理】模型及推理等级:供应商模型精细化管理,支持模型分类(通用模型、对话模型、潜入模型、文生图模型);并针对对话模型,支持推理登陆(Default、Low、High、Max); 5、【新增】输入框支持关联文件:新增“+“按钮功能,支持选择文件并关联到当前会话,便于Agent调用文件内容; 6、【重构】代码模块化重构:同一职责域代码收拢在单一模块内,对外仅暴露最小必要接口,避免跨模块散落同职责的实现细节; […]

2 mins read

Evolver:让探索留下策略 – Florian

【摘要】不训练基础模型,而是把执行中产生的程序性知识整理成策略资产,再送回后续任务的上下文。这里更值得关注的不是“Agent 会不会自动变聪明”,而是一个工程问题:怎样把一次性的执行记录,变成有适用条件、能被检索、也能被撤回的行动依据? 阅读全文 PakarPBN A Private Blog Network (PBN) is a collection of websites that are controlled by a single individual or organization and used primarily to build backlinks to a “money site” in order to influence its ranking in search engines such as Google. The core idea behind a PBN is based on the […]

1 min read

RSI:进化不只发生在模型 – Florian

【摘要】AI 已经进入代码编写、算法优化和模型研发流程。但一次任务完成之后,系统留下的可能是可复用能力,也可能只是一份答案和散落的日志。两者的差别,要到下一次面对相似问题时才会显现:它能利用上次的发现,还是又要支付一遍探索成本? 递归自我改进(Recursive Self-Improvement,RSI)关 阅读全文 PakarPBN A Private Blog Network (PBN) is a collection of websites that are controlled by a single individual or organization and used primarily to build backlinks to a “money site” in order to influence its ranking in search engines such as Google. The core idea behind a PBN is based […]

1 min read

许愿式编程:我把 Typability 改成了能日常顶替 Typora 的样子 – 树欲静·而风不止

为什么要 fork   我用 Typora 挺长时间了,它确实好用,但有两个问题一直绕不过去 要花钱。网上那些”激活版”破解得不彻底——过一阵又弹试用提示,需要清除缓存,反复折腾。 改不动。用着用着总有些小地方不顺手(弹窗逻辑、窗口行为、菜单状态),但在闭源软件里只能忍着。   所以我找了开源基座:Typability 正好符合我的口味。它是一个基于 Milkdown 的所见即所得编辑器,Tauri 打包(体积小、内存占用低),Fluent UI 界面,还能用 Mica/亚克力窗口效果。上游最后的版本是 0.4.1,我从这里开始改——功能骨架都有了,但日常用起来到处是”小别扭”。   这里得先说句感谢的话:Typability 的底子是真的不错,感谢原作者 SimonShiki 。Milkdown 的 WYSIWYG 内核、Tauri 的打包链路、Fluent 的组件体系和 Nord/Tokyo 主题、多语言、查找替换、双栏编辑、LaTeX 与 Mermaid,上游都已经搭好了。我做的更多是”补齐细节,优化操作”,而不是从零造一个 Markdown 编辑器。   于是 fork,然后一路改到 0.6.3。下面把这几个版本做了什么、踩了哪些坑、以及它现在到底能不能替代 Typora,完整记一遍。 版本一览 版本 主题 0.5.0 窗口记忆、保存/关闭语义、拖拽打开、标题栏路径、源码视图、检查更新、构建修复 0.6.1 双栏编辑器与源码视图互斥 0.6.2 链接气泡加宽 + OPEN 按钮、默认文档链接指向本仓库 0.6.3 查找替换高亮、匹配位置修正、自动聚焦 0.5.0:先把”每天都要碰”的别扭解决掉 1. 记住窗口大小和位置   原来每次启动都是固定的 540×680 居中窗口,每次都要手动拖大、挪到副屏。 […]

2 mins read

Embedding 与向量数据库:给每段文字发一个坐标,然后找邻居 – 朱瑞福 – 博客园

“把模型跑起来”只是本地大模型项目的第一步。真正让它对公司业务有用的,是一套给它”递资料”的系统——而这套系统的地基,就是 embedding 和向量数据库。这两个词听起来很玄,本文用一个 20 行代码的实验把它们拆开看清楚。 一、先看全景:它们在一个本地大模型项目里的位置 一个典型的本地大模型项目,不是”把模型跑起来”就完事的。假设一家公司把 qwen 部署在了自己的服务器上,很快就会发现:问它通用问题头头是道,问它”我们公司的报销制度是什么”就一本正经地胡编。模型训练时没见过这家公司的任何文档,它不可能知道。 解决办法是把公司的资料作为上下文,随问题一起喂给模型。那么问题来了:用户提问的时候,系统怎么知道该把公司几千份文档里的哪几份递给模型? 这就是 embedding 和向量数据库登场的位置。整个系统大概长这样: 【入库:一条自动化管道】 公司文档(PDF/Word/网页/扫描件…) → 解析提取文字 → 清洗 → 切成分块 → 每块文字做 embedding(变成一个向量) → 存入向量数据库 【查询:每次提问时】 用户提问 → 提问也做 embedding(变成一个向量) → 拿这个向量去向量数据库做语义搜索 → 取回语义最接近的前 N 条文档块 → 拼进 prompt,连同问题一起交给大模型 → 模型基于资料作答 注意入库那条管道:公司的文档是各种格式、持续更新的混合体,”把文档变成可检索的知识库”本身就是一个需要 pipeline 系统来自动化的工程(这也正是做过数据管道的后端工程师熟悉的味道——它就是一条 ETL,终点从数仓换成了向量库)。 所以一个完整的本地大模型项目是:用户通过搭好的系统上传各种格式的文件,管道自动处理入库;用户在问答界面提问,系统检索出最相关的资料递给模型,得到有公司自己味道的回答。 embedding 和向量数据库,就是这条链路里”找资料”的那一环——本文只讲它们。 二、embedding 到底是个啥:把对象落到语义空间的一个位置 “Embedding”是个一直没有正经中文翻译的词,直译”嵌入”,有人译”向量化”——但对没接触过的人来说,哪个都是黑话。它实际干的事情其实一句话能说清: 把一段文字(或图片、视频),按照模型定义好的维度,落到一个坐标系里。embedding 的结果,就是它在这个坐标系里的位置。 二维、三维的坐标我们还能在脑子里画出来:北京在上海北边、深圳在上海南边,位置关系一目了然。而 […]

2 mins read